Cómo funciona
Detectar el saque y el final de cada punto en video amateur, explicado paso a paso: qué técnica usamos, de qué paper sale y qué número la justifica.
El problema
Una cámara fija detrás de una de las paredes de fondo graba el partido entero. Queremos una lista de intervalos [saque, fin], uno por punto. Lo difícil no es el pádel sino el video amateur:
- Ruido de otras canchas. Pelotazos, gritos y jugadores de las canchas vecinas aparecen en el audio y en la imagen.
- Imagen pobre. Vidrios empañados o sucios, gran angular con distorsión, luz de galpón o de noche, jugadores cercanos que salen de cuadro.
- Mucho tiempo muerto que se parece al juego. Juntar pelotas, peloteos entre puntos, pelotas quietas tiradas en la cancha.
- Cada club es distinto. Altura de la cámara, colores, encuadre. Lo que se aprende en una cancha tiene que servir en otra.
Regla del proyecto: el marcador que aparece sobreimpreso en el video nunca entra al modelo. Lo leemos con OCR sólo para validar: cada cambio de marcador debería corresponder a exactamente un punto terminado.
Etiquetas: la verdad contra la que medimos
Tres partidos en tres clubes distintos (44, 33 y 39 minutos) se etiquetaron con un protocolo escrito: el punto empieza cuando la paleta del sacador toca la pelota en el primer saque y termina cuando la pelota muere. Una falta seguida de segundo saque es el mismo punto. Las etiquetas las hicieron agentes de IA revisando hojas de contacto a 1 y 4 cuadros por segundo, con el marcador tapado. En total: 275 puntos.
// labels_v2/lgl.json (extracto)
{ "start": 42.2, "end": 61.5, "conf": 0.85,
  "note": "saque del lado cercano; peloteo largo, terminó en la red" },
{ "start": 78.6, "end": 82.0, "conf": 0.90,
  "note": "saque del lado cercano; terminó con un smash ~81.5" }
Auditoría con una señal débil
El marcador no sirve para detectar, pero sí para sospechar: si entre dos cambios de marcador hay cero o dos puntos etiquetados, algo está mal. Esas ventanas se volvieron a revisar a mano, sin mostrar el marcador. Es la idea de confident learning (Northcutt et al., 2021): usar una señal ruidosa para encontrar errores de etiqueta, no para reemplazarlas.
| Partido | Alertas | Confirmadas | Coincidencia con el marcador |
|---|---|---|---|
| Fecha 1 de liga | 9 | 4 | 96 % |
| Set 3 | 34 | 21 | 86 % |
| Partido 1 | 29 | 22 | 90 % |
El error más común era confundir un punto corto con «una falta y segundo saque». La regla que lo resolvió: si el saque siguiente viene de la otra mitad de la cancha, es un punto nuevo.
Jugadores en coordenadas de cancha
Es la señal que más pesa. Tres pasos:
- Pose. YOLO11-pose (Ultralytics, 2024; familia YOLO de Redmon et al., 2016) detecta personas y 17 puntos del cuerpo con el esquema de COCO (Lin et al., 2014), a 15 cuadros por segundo sobre la imagen en 1080p.
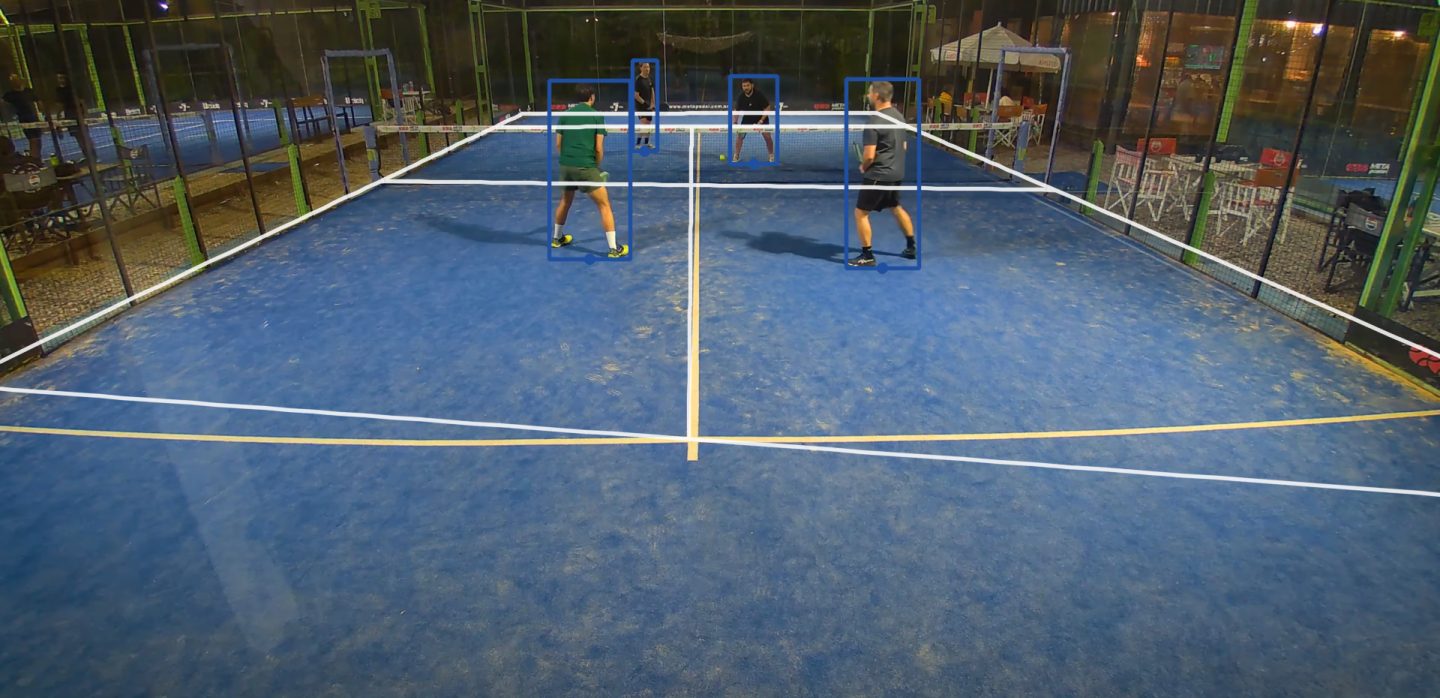
- Homografía. Una vez por cámara marcamos seis puntos del piso cuya posición real conocemos (la T de saque, el centro de la red, los extremos de la red y las esquinas del fondo). Con eso se estima una homografía, la transformación proyectiva que lleva el plano del piso en la imagen al plano de la cancha en metros (Hartley y Zisserman, 2004).
- Filtrar y describir. El pie de cada persona se proyecta a la cancha. Quien cae afuera, sea de una cancha vecina, del público o del pasillo, se descarta. Con los que quedan calculamos 34 números cada 0,2 s: cuántos hay en cada mitad, a qué distancia de la red, qué tan rápido se mueven, quién tiene el brazo arriba, quién está al fondo y quieto, y si hay un jugador al fondo de cada lado en diagonal, que es la formación típica del saque.
# court.py: seis puntos del piso -> homografía imagen -> metros
COURT = np.float32([(5, 3.05), (5, 10), (0, 10), (10, 10), (0, 20), (10, 20)])
H, _ = cv2.findHomography(np.float32(landmarks[match]), COURT)
pies_en_metros = cv2.perspectiveTransform(pies_en_pixeles, H)
Por qué importa: una grilla de movimiento en píxeles funciona muy bien dentro de un mismo partido, pero se rompe al cambiar de cámara. Las posiciones en metros significan lo mismo en cualquier club.
Audio: útil, pero engañoso
Cada golpe de pelota es un transitorio agudo. Lo medimos con spectral flux, el aumento de energía entre ventanas consecutivas del espectrograma entre 1,5 y 10 kHz, una técnica clásica de detección de onsets (Bello et al., 2005).
Sumar el audio a las señales de jugadores no mejoró el resultado entre clubes. Confirma la intuición inicial: el sonido solo no alcanza.
Embeddings de imagen
DINOv2 (Oquab et al., 2023) es un modelo de visión autosupervisado cuyos vectores describen bien una escena sin entrenarlo para nada en particular. Tomamos 5 cuadros por segundo, tapamos la zona del marcador y guardamos el vector global más una grilla de 3 × 4 zonas. Esos vectores se reducen a 96 números con PCA. Solos generalizan peor que los jugadores, pero ayudan a ubicar el final del punto: cuando todos dejan de jugar, la escena cambia de una forma que la pose no captura del todo.
Modelo temporal
El partido se corta en pasos de 0,2 s. Para cada paso el modelo produce tres probabilidades: en juego, empieza un punto acá y termina un punto acá. Es una red convolucional 1D con dilataciones crecientes (1, 2, 4, 8, 16, dos veces), la misma idea de WaveNet (van den Oord et al., 2016) y de las TCN (Bai, Kolter y Koltun, 2018), usada para segmentar acciones en video por MS-TCN (Farha y Gall, 2019). Cada salida ve unos 50 segundos de contexto, suficiente para entender «hubo un saque hace 20 segundos y todos siguen corriendo».
class Net(nn.Module):
    # 10 bloques residuales, kernel 5, dilaciones 1..16: ~50 s de contexto
    def __init__(s, d_in, h=64):
        s.inp = nn.Sequential(nn.Dropout(0.3), nn.Conv1d(d_in, h, 1))
        s.blocks = nn.ModuleList([nn.Sequential(
            nn.Conv1d(h, h, 5, padding=2 * d, dilation=d), nn.GELU(),
            nn.Dropout(0.1), nn.Conv1d(h, h, 1)) for d in (1, 2, 4, 8, 16) * 2])
        s.out = nn.Conv1d(h, 3, 1)          # en juego · inicio · fin
Detalles que importaron: cada partido se normaliza con su propia media y desvío, para que «rápido» signifique rápido para esa cámara; se entrena con AdamW (Loshchilov y Hutter, 2019) y un ciclo de learning rate (Smith y Topin, 2017); y el resultado final promedia 20 redes, 5 semillas por cada una de 4 combinaciones de señales. Un ensamble así es simple y estabiliza mucho (Lakshminarayanan et al., 2017).
De probabilidades a puntos
Cortar la curva en un umbral da intervalos, pero los peloteos largos, con globos y pausas, se parten en dos. La solución es una regla del deporte: todo punto empieza con un saque. Si dos intervalos están separados por menos de 6 segundos y al comienzo del segundo no hay un pico de «inicio», se unen.
# decode(): umbral 0,6 -> segmentos -> unir huecos sin saque -> afinar bordes
if hueco < 1.0 or (hueco < 6.0 and max(P_inicio[cerca_del_comienzo]) < 0.4):
    unir(anterior, segmento)
inicio = argmax(P_inicio[±2 s]);  fin = argmax(P_fin[±2 s])
Sólo esta regla subió el acierto medio de 0,84 a 0,87.
Evaluación honesta
Con pocos partidos es fácil engañarse. Tres reglas:
- Dejar un club afuera. Cada partido se predice con modelos entrenados sólo con los otros dos. Es la pregunta real: ¿funciona en una cancha nueva? El cambio de distribución entre clubes es el problema central (Quiñonero-Candela et al., 2009).
- Ajuste anidado. Los parámetros del decodificador también se eligen sin mirar el partido evaluado. Elegirlos mirando el resultado infla los números (Varma y Simon, 2006).
- Coincidencia uno a uno. Un punto detectado cuenta si se superpone al menos un 30 % (IoU) con uno etiquetado, y cada etiqueta se usa una sola vez.
| Versión | Entrenado con | F1 en club nuevo |
|---|---|---|
| Movimiento y pose en píxeles + audio + imagen | 1 club | 0,58 – 0,65 |
| Jugadores en metros | 1 club | 0,73 – 0,75 |
| Jugadores en metros | 2 clubes | 0,84 |
| + regla del saque | 2 clubes | 0,87 |
| + ensamble con audio e imagen | 2 clubes | 0,89 |
Como contraste: la primera versión daba 0,92 evaluada dentro del mismo partido, y cayó a 0,6 en un club nuevo. Medir mal habría escondido el problema.
Resultado final por partido: F1 0,93, 0,91 y 0,89. El saque se ubica a menos de 1 segundo en el 70–82 % de los puntos; el final, en el 49–64 %.
¿Quién ganó el punto? Marcador automático
El paso siguiente es generar el marcador sin leerlo: decidir quién ganó cada punto y llevar la cuenta con las reglas. El marcador real se usa sólo para entrenar y medir, siempre dejando afuera el club que se evalúa.
1. Qué pareja está de cada lado
Cada jugador se reconoce por el color de su remera y su short, medidos sobre los puntos del cuerpo que da la pose. Agrupando esos colores salen cuatro identidades; las dos que aparecen juntas del mismo lado forman una pareja. Un modelo oculto de Markov suaviza la secuencia, porque los lados sólo cambian entre games.
Sorpresa amateur: el reglamento dice que se cambia de lado en los games impares. En la Fecha 1 se cumple exacto; en el Set 3 y en el Partido 1 las parejas no cambiaron de lado en todo el set. Por eso los lados salen de ver a los jugadores, no del reglamento.
2. Quién saca
La formación del saque (un jugador al fondo de cada lado, en diagonal, quietos y el sacador con el brazo abajo) se reconoce con un clasificador simple: acierta el lado del saque en el 91–100 % de los puntos de un club nuevo. El que saca gana el 60–65 % de los puntos.
3. Dónde muere la pelota
Un detector de objetos general (YOLO11 entrenado en COCO, clase «pelota») corre sobre cada cuadro a 30 fps. Las detecciones se unen en trayectorias con un modelo de velocidad constante; las pelotas quietas —tiradas en la cancha o en la mano del que espera para sacar— se descartan porque no se mueven. Cada vez que la pelota pasa de bajar a subir en la imagen hay un pique o un golpe bajo, y su posición en metros dice de qué lado fue.
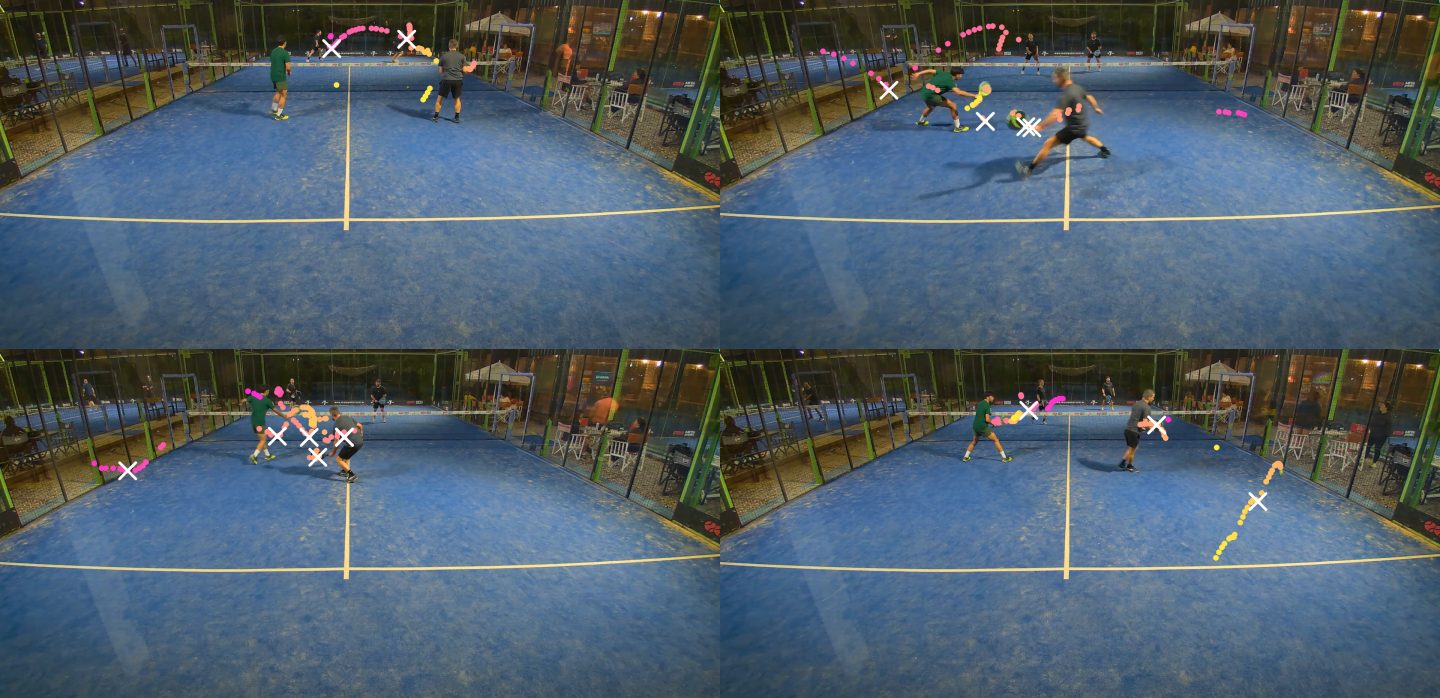
La física del juego aparece sola: si el último pique fue en tu lado, casi siempre perdiste (doble pique o pelota a la red). Siete señales bastan —lado del último pique, posición de los piques, de qué lado queda la pelota y quién estaba en la red— y rinden mejor que modelos con cientos de variables.
4. Las reglas como decodificador
Con punto de oro, un game termina cuando una pareja llega a su cuarto punto; el set, a 6 con dos de diferencia o con tie-break a 7. Un programa dinámico recorre todos los marcadores posibles y elige la secuencia de ganadores más probable que respete las reglas, el saque alternado por games y la ventaja del que saca. También admite un punto de más o de menos, por cortes del video o errores de detección.
| Partido (club nuevo) | Punto bien asignado | Game bien asignado |
|---|---|---|
| Fecha 1 de liga | 64 % | 69 % |
| Set 3 | 74 % | 82 % |
| Partido 1 | 75 % | 67 % |
Con los límites de los puntos marcados a mano; todo automático, el acierto por punto es 62–76 %. El primer set del Partido 1 sale exacto (6–3). Pero el marcador se arrastra: en la Fecha 1, un solo game mal asignado al principio desplaza todo lo que sigue. Para llegar a un marcador confiable falta un detector de pelota entrenado para pádel (los generales confunden raquetas fluorescentes y remeras) y más partidos etiquetados.
Lo que no funcionó
La pelota, buscada por color
La intuición era buena: el pique y el golpe de la pelota definen el punto. Buscamos manchas amarillo-verdosas que se mueven entre tres cuadros, sacamos las líneas y las pelotas quietas con un fondo mediano, descartamos lo que cae sobre una persona y unimos detecciones en trayectorias cortas.
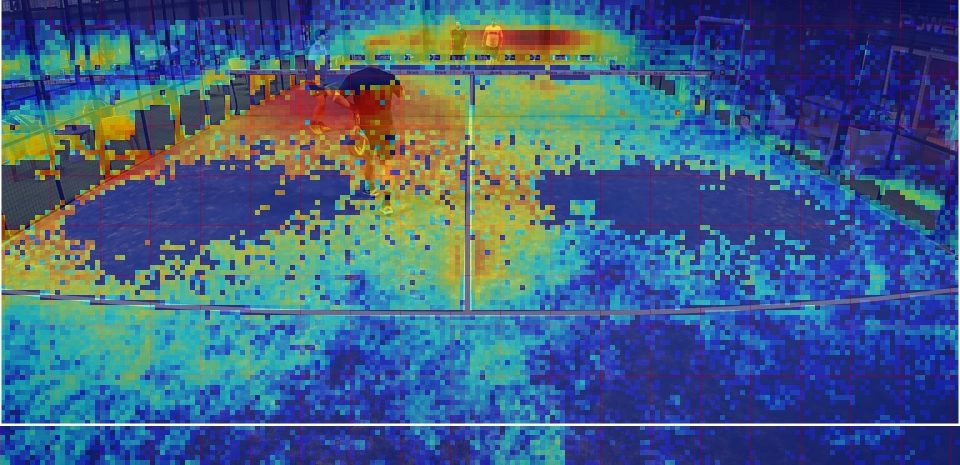
Por sí sola, esta señal separa juego de pausa apenas mejor que el azar (AUC 0,60–0,68) y al sumarla al modelo empeoró un poco. Hace falta un detector entrenado, como TrackNet (Huang et al., 2019).
Señales atadas a la cámara
Grillas de movimiento y de pose en píxeles aprenden la cancha, no el juego: rinden muy bien en el partido donde se entrenan y mal en otro club.
Qué sigue
- Un detector de pelota entrenado para pádel (estilo TrackNet): afinaría el final de cada punto y, sobre todo, quién lo ganó.
- Más clubes: cada club nuevo en el entrenamiento mejoró bastante el resultado en los demás.
- Reconocer mejor el saque del lado lejano, donde está la mayoría de los puntos cortos perdidos.
- Corregir la distorsión del lente en la calibración: cerca de la cámara el error es de 0,5 a 1 metro.
Referencias
- Redmon, Divvala, Girshick y Farhadi. You Only Look Once: Unified, Real-Time Object Detection. CVPR 2016.El origen de la familia YOLO que usamos para detectar jugadores.
- Ultralytics. YOLO11, 2024.El modelo de pose concreto (yolo11m-pose).
- Lin et al. Microsoft COCO: Common Objects in Context. ECCV 2014.Define los 17 puntos del cuerpo (hombros, muñecas, caderas…) que usamos para brazos arriba o saque de abajo.
- Hartley y Zisserman. Multiple View Geometry in Computer Vision, 2.ª ed. Cambridge University Press, 2004.Homografías: cómo pasar del plano del piso en la imagen a metros reales.
- Bello et al. A Tutorial on Onset Detection in Music Signals. IEEE Trans. Speech and Audio Processing, 2005.Spectral flux para detectar golpes en el audio.
- Oquab et al. DINOv2: Learning Robust Visual Features without Supervision. 2023.Los embeddings de imagen.
- van den Oord et al. WaveNet: A Generative Model for Raw Audio. 2016.Convoluciones dilatadas para ver mucho contexto con pocas capas.
- Bai, Kolter y Koltun. An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling. 2018.Por qué una TCN simple compite con las redes recurrentes en secuencias.
- Farha y Gall. MS-TCN: Multi-Stage Temporal Convolutional Network for Action Segmentation. CVPR 2019.Segmentar un video largo en acciones cuadro a cuadro, el mismo tipo de problema.
- Lakshminarayanan, Pritzel y Blundell. Simple and Scalable Predictive Uncertainty Estimation using Deep Ensembles. NeurIPS 2017.Promediar varias redes entrenadas con distinta semilla.
- Loshchilov y Hutter. Decoupled Weight Decay Regularization (AdamW). ICLR 2019.El optimizador.
- Smith y Topin. Super-Convergence: Very Fast Training of Neural Networks Using Large Learning Rates. 2017.El ciclo de learning rate (one-cycle).
- Varma y Simon. Bias in error estimation when using cross-validation for model selection. BMC Bioinformatics, 2006.Por qué el ajuste del decodificador es anidado.
- Quiñonero-Candela, Sugiyama, Schwaighofer y Lawrence (eds.). Dataset Shift in Machine Learning. MIT Press, 2009.El marco para «funciona en un club, falla en otro».
- Northcutt, Jiang y Chuang. Confident Learning: Estimating Uncertainty in Dataset Labels. JAIR, 2021.Usar una señal ruidosa, el marcador en este caso, para encontrar etiquetas equivocadas.
- Huang et al. TrackNet: A Deep Learning Network for Tracking High-speed and Tiny Objects in Sports Applications. 2019.El camino para detectar bien la pelota.